SDXL 에서는 FP8 를 사용않고 있었다. SDUI 에서도 FP8 이 기본적으로 활성화 되지 않는다. 문득 조금 이상하다는 생각이 들어 찾아봤다.
- 우선 SDUI 에서는 Optimizations 항목에 FP8 관련 설정이 아래와 같이 2개 있다.
① FP8 weight (Use FP8 to store Linear/Conv layers' weight. Require pytorch>=2.1.0.) ◎ Disable ◎ Enable for SDXL ◎ Enable
② Cache FP16 weight for LoRA (Cache fp16 weight when enabling FP8, will increase the quality of LoRA. Use more system ram.)
- ① 을 활성화하면 기본적으로 FP8 을 사용하게 된다. 실제로 해보면 성능 향상(이미지 생성속도)이 없다. 단 메모리는 FP8을 사용하는 만큼 적게 사용한다. FP8을 활성화 하는 경우 일부 LoRA 를 사용할 수 없다. 왜인지는 모르겠지만 오류 발생한다.
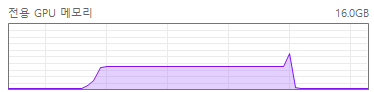
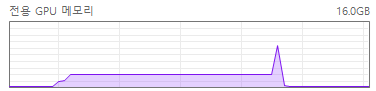
- SDXL 메모리 사용량
FP8:  3.80 GB
FP16: 5.23 GB
SDXL FP16
SDXL FP8
주) VAE 는 동일하게 FP32 사용한다.
- ②는 캐시관련된거라 성능에 관련이 없다.
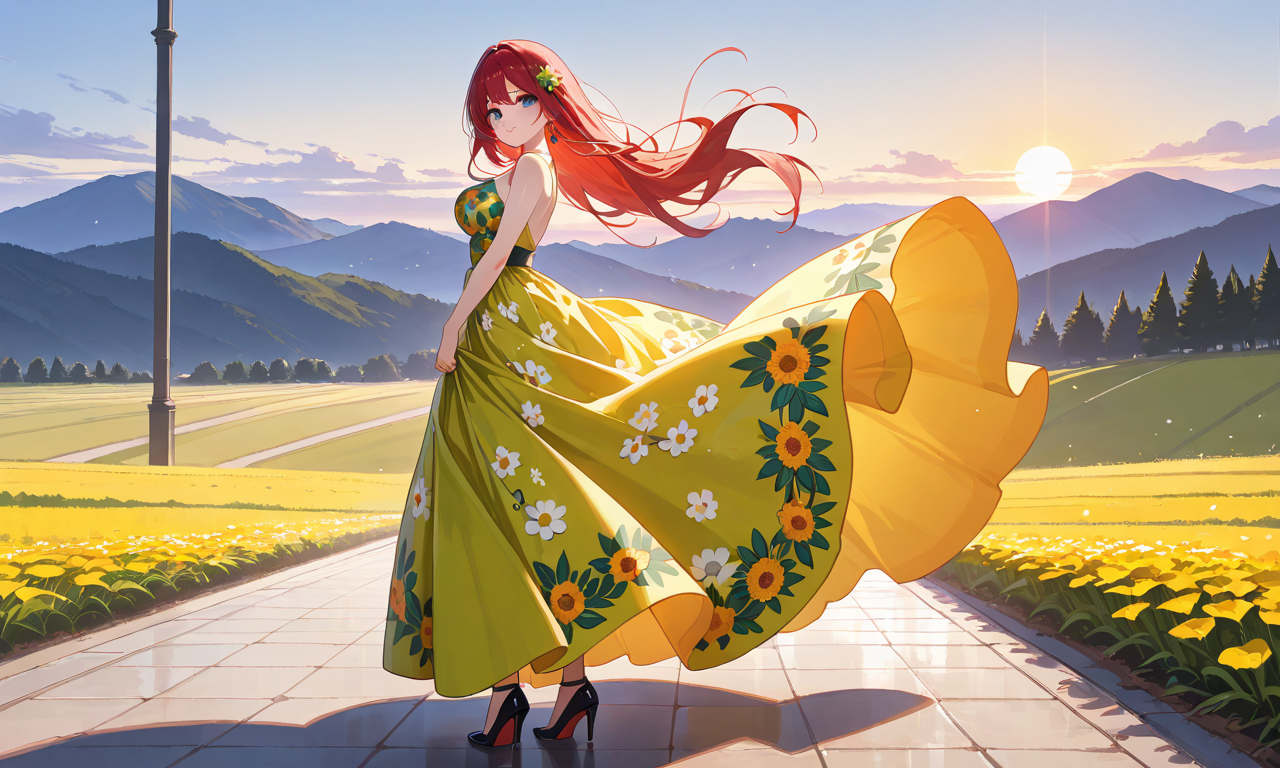
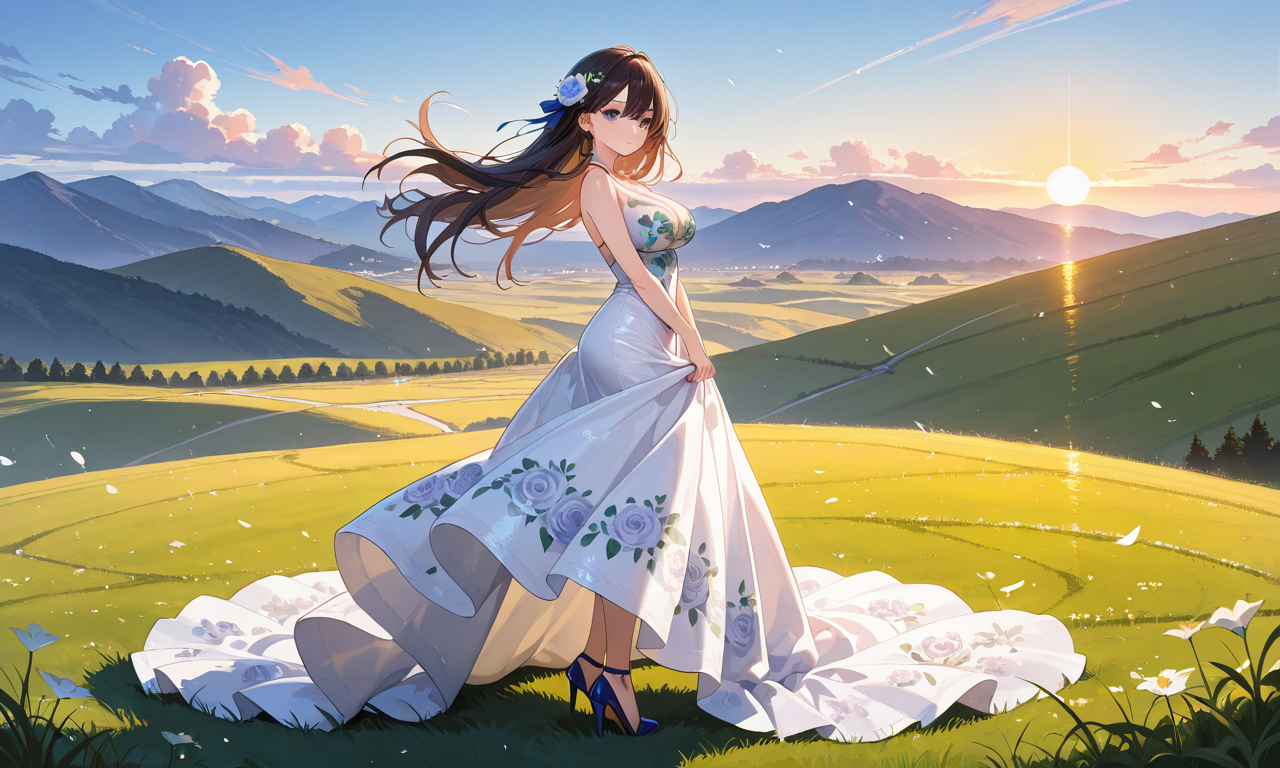
- 결론적으로 써도 성능 향상이 없고, LoRA 호환성만 떨어뜨리기 때문에 사용 안하는 거다. 결과물도 다르다. (단 FP16이 항상 더 좋은 결과를 내주는건 아니다) FLUX.1 dev 는 FP8 을 쓰면 효과가 상당히 좋은데 (이미지 생성속도가 빨라지는데) 유독 SDXL 에서는 효과가 없다.
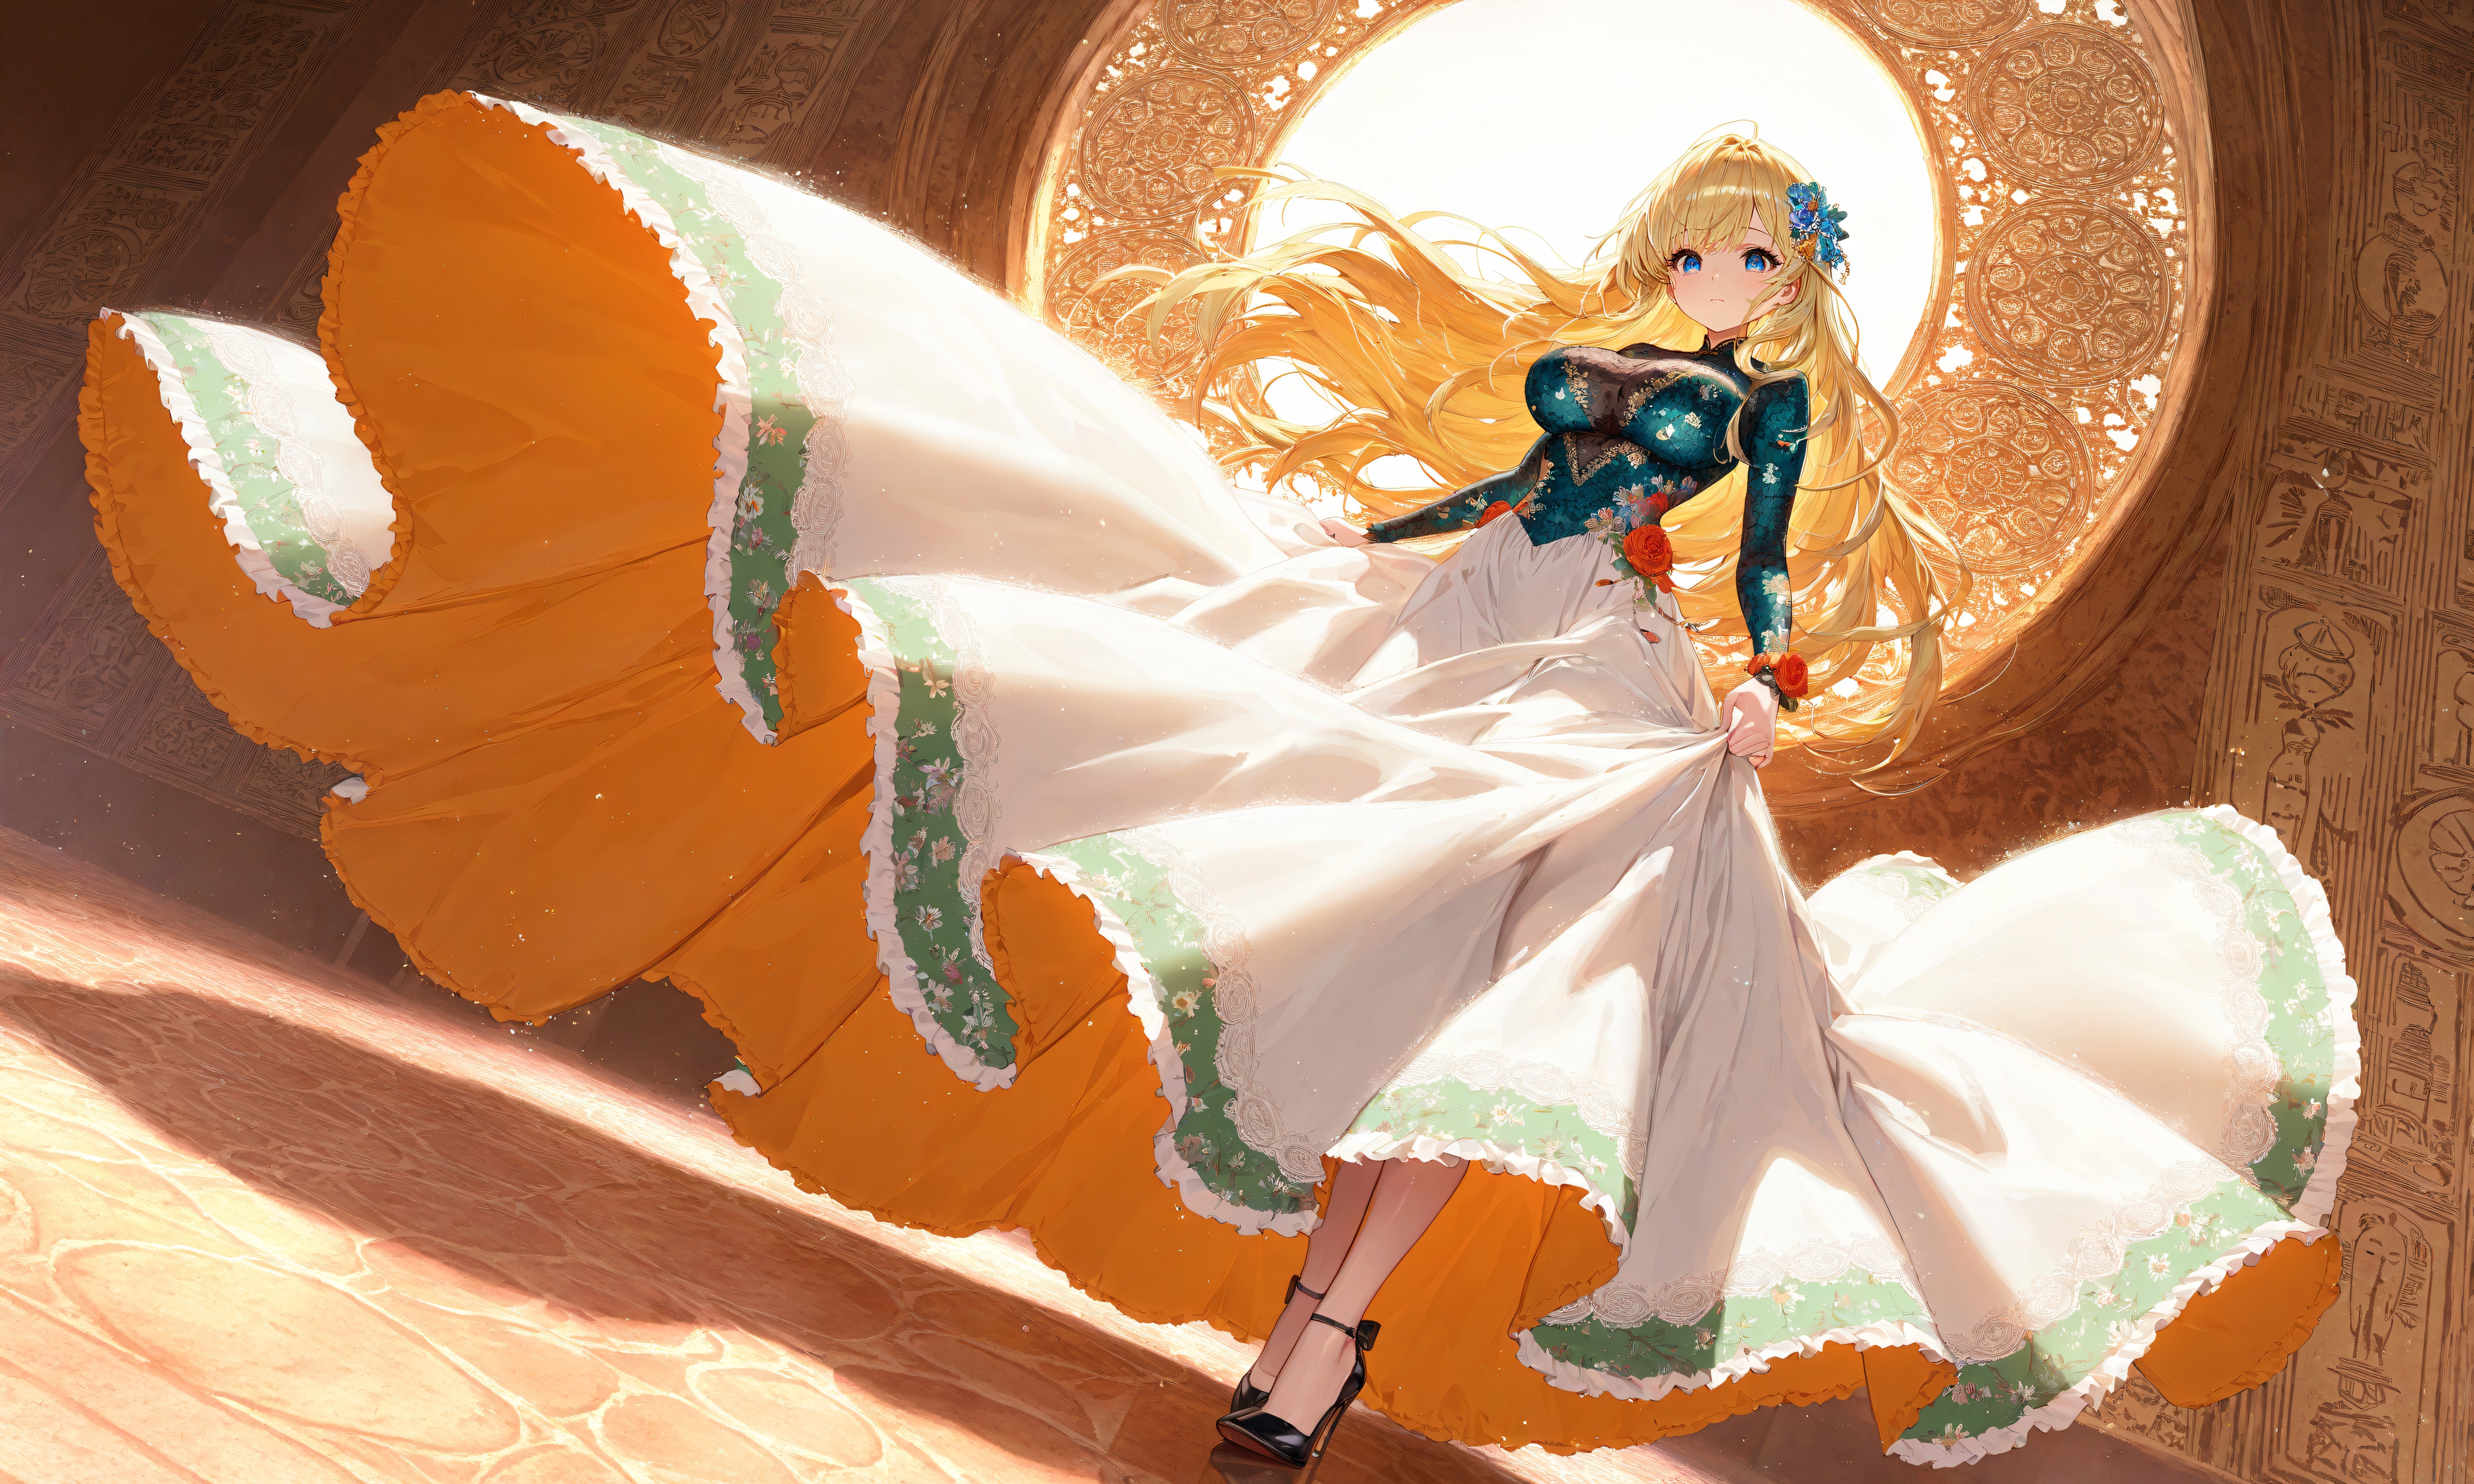
- 아래는 같은 프롬프트, 같은 파라메터를 사용해서 만든 이미지다. 어떤게 좋다고는 할 수 없지만 왠지 FP16 이 더 빛나 보인다.
딥 시크 R1 을 Python vLLM 을 사용해 로컬에서 실행해 보았다. DeepSeek-R1-Distill-Qwen-1.5B 모델을 사용했는데, 이 모델은 DeepSeek R1 에서 Distill 된 모델중 가장 작은 모델로, 수학 모델이다. 한글을 잘 인식하질 못해서 영어로 질문했다. 인터넷에서 영문 수학 문제를 검색해 문의해보았다.
인터넷을 찾아보면 한글 지원하는 모델도 쉽게 구할 수 있고, 7B 모델만 되어도 한글 잘 인식한다고 한다. 하지만 필자의 사양에서는 못 돌린다. 그래서 INT8 으로 양자화된 모델을 찾고 있기도 하다.
서버 사양은 Ubuntu 22.04, i7-7700K, 32GB, RTX 2060 12G 이다. 아래와 같이 실행했다.
$ mkdir DeepSeek-R1-Distill-Qwen-1.5B $ cd DeepSeek-R1-Distill-Qwen-1.5B $ python3 -m venv venv $ . venv/bin/activate (venv) $ pip install vllm (venv) $ vi run.py from vllm import LLM, SamplingParams
for output in outputs: print(output.outputs[0].text) (venv) $ python run.py
실행 결과는 아래와 같다. 보기좋게 편집되어있다. 질문은 생일을 맞추는 문제인데, "2일 전에는 25살, 내년에는 28살"일 때 생일을 묻는 문제로, 생일은 12월 31일이다. 정확하게 맞췄다. 약 25초 정도 걸렸다. VRAM 사용량은 약 9.5GB 정도 된다. (nvidia-smi 으로 측정)
(venv) $ python run.py
INFO 02-00 18:51:00 __init__.py:183] Automatically detected platform cuda.
WARNING 02-00 18:51:02 config.py:2368] Casting torch.bfloat16 to torch.float16.
INFO 02-00 18:51:07 config.py:526] This model supports multiple tasks: ...
INFO 02-00 18:51:07 llm_engine.py:232] Initializing a V0 LLM engine (v0.7.1) ...
INFO 02-00 18:51:08 cuda.py:184] Cannot use FlashAttention-2 backend for Volta and Turing GPUs.
INFO 02-00 18:51:08 cuda.py:232] Using XFormers backend.
INFO 02-00 18:51:09 model_runner.py:1111] Starting to load model
deepseek-ai/DeepSeek-R1-Distill-Qwen-1.5B...
INFO 02-00 18:51:09 weight_utils.py:251] Using model weights format ['*.safetensors']
INFO 02-00 18:51:10 weight_utils.py:296] No model.safetensors.index.json found in remote.
Loading safetensors checkpoint shards:   0% Completed | 0/1 [00:00<?, ?it/s]
Loading safetensors checkpoint shards: 100% Completed | 1/1 [00:00<00:00,  1.06it/s]
Loading safetensors checkpoint shards: 100% Completed | 1/1 [00:00<00:00,  1.06it/s]

INFO 02-00 18:51:11 model_runner.py:1116] Loading model weights took 3.3460 GB
INFO 02-00 18:51:12 worker.py:266] Memory profiling takes 1.05 seconds
INFO 02-00 18:51:12 worker.py:266] the current vLLM instance can use
total_gpu_memory (11.55GiB) x gpu_memory_utilization (0.90) = 10.40GiB
INFO 02-00 18:51:12 worker.py:266] model weights take 3.35GiB;
non_torch_memory takes 0.04GiB; PyTorch activation peak memory takes 1.41GiB;
the rest of the memory reserved for KV Cache is 5.60GiB.
INFO 02-00 18:51:12 executor_base.py:108] # CUDA blocks: 13097, # CPU blocks: 9362
INFO 02-00 18:51:12 executor_base.py:113] Maximum concurrency for 8000 tokens per request: 26.19x
INFO 02-00 18:51:14 model_runner.py:1435] Capturing cudagraphs for decoding.
This may lead to unexpected consequences if the model is not static.
To run the model in eager mode, set 'enforce_eager=True' or use '--enforce-eager' in the CLI.
If out-of-memory error occurs during cudagraph capture,
consider decreasing `gpu_memory_utilization` or switching to eager mode.
You can also reduce the `max_num_seqs` as needed to decrease memory usage.
Capturing CUDA graph shapes: 100%|█████████████| 35/35 [00:09<00:00,  3.63it/s]
INFO 02-00 18:51:24 model_runner.py:1563] Graph capturing finished in 10 secs, took 0.19 GiB
INFO 02-00 18:51:24 llm_engine.py:429] init engine (profile, create kv cache, warmup model)
took 13.48 seconds
INFO 02-00 18:51:24 chat_utils.py:330] Detected the chat template content format to be 'string'.
You can set `--chat-template-content-format` to override this.
Processed prompts: 100%|███████████████████████
[00:04<00:00,  4.14s/it, est. speed input: 9.66 toks/s, output: 81.16 toks/s]
<think>
To determine the day of the birthday, I start by analyzing the information given.

First, it's stated that the day before yesterday, the person was 25.
This means that yesterday was the birthday day, and today is the day after birthday.

Next, it's mentioned that the next year, the person will be 28.
This implies that the current age is 25 plus 1, which is 26.

Since the person will be 28 in the next year, their birthday must be on December 31st.
This is because the next year's birthday will occur on the same date,
and the age will increase by one year.

Therefore, the birthday is December 31st.
</think>

To determine the day of your birthday, let's analyze the information step by step:

1. **Day Before Yesterday:**
   - You were **25** years old the day before yesterday.
   - This means **yesterday** was your birthday day.

2. **Next Year:**
   - You will be **28** years old in the next year.
   - If you are currently 26 years old, your birthday will be on **December 31st** because:
     - **Today** is **December 31st**.
     - **Tomorrow** will be **January 1st**, and you'll turn **27**.
     - **Next Year** (two years from now) you'll be **28** years old.

**Conclusion:**

Your birthday is on **\boxed{December 31st}**.
Think 태그에 보면 사고의 흐름을 볼 수 있다. 이런게 나오긴 한다 정도로 생각하면 된다. 정답은 맞췄지만 논리적 사고를 한다기 보다는 문장의 흐름, 패턴을 검색해 유추한다고 생각한다.
DeepSeek R1는 중국의 DeepSeek 에서 개발한 LLM 모델입니다. 쉽게 말하면 ChatGPT 같이 사용할 수 있는 AI 라고 생각하면 됩니다. 요즘에 주목받는 AI인데요, 그 이유중 하나가 성능이 좋고 무었보다 오픈소스이기 때문입니다.
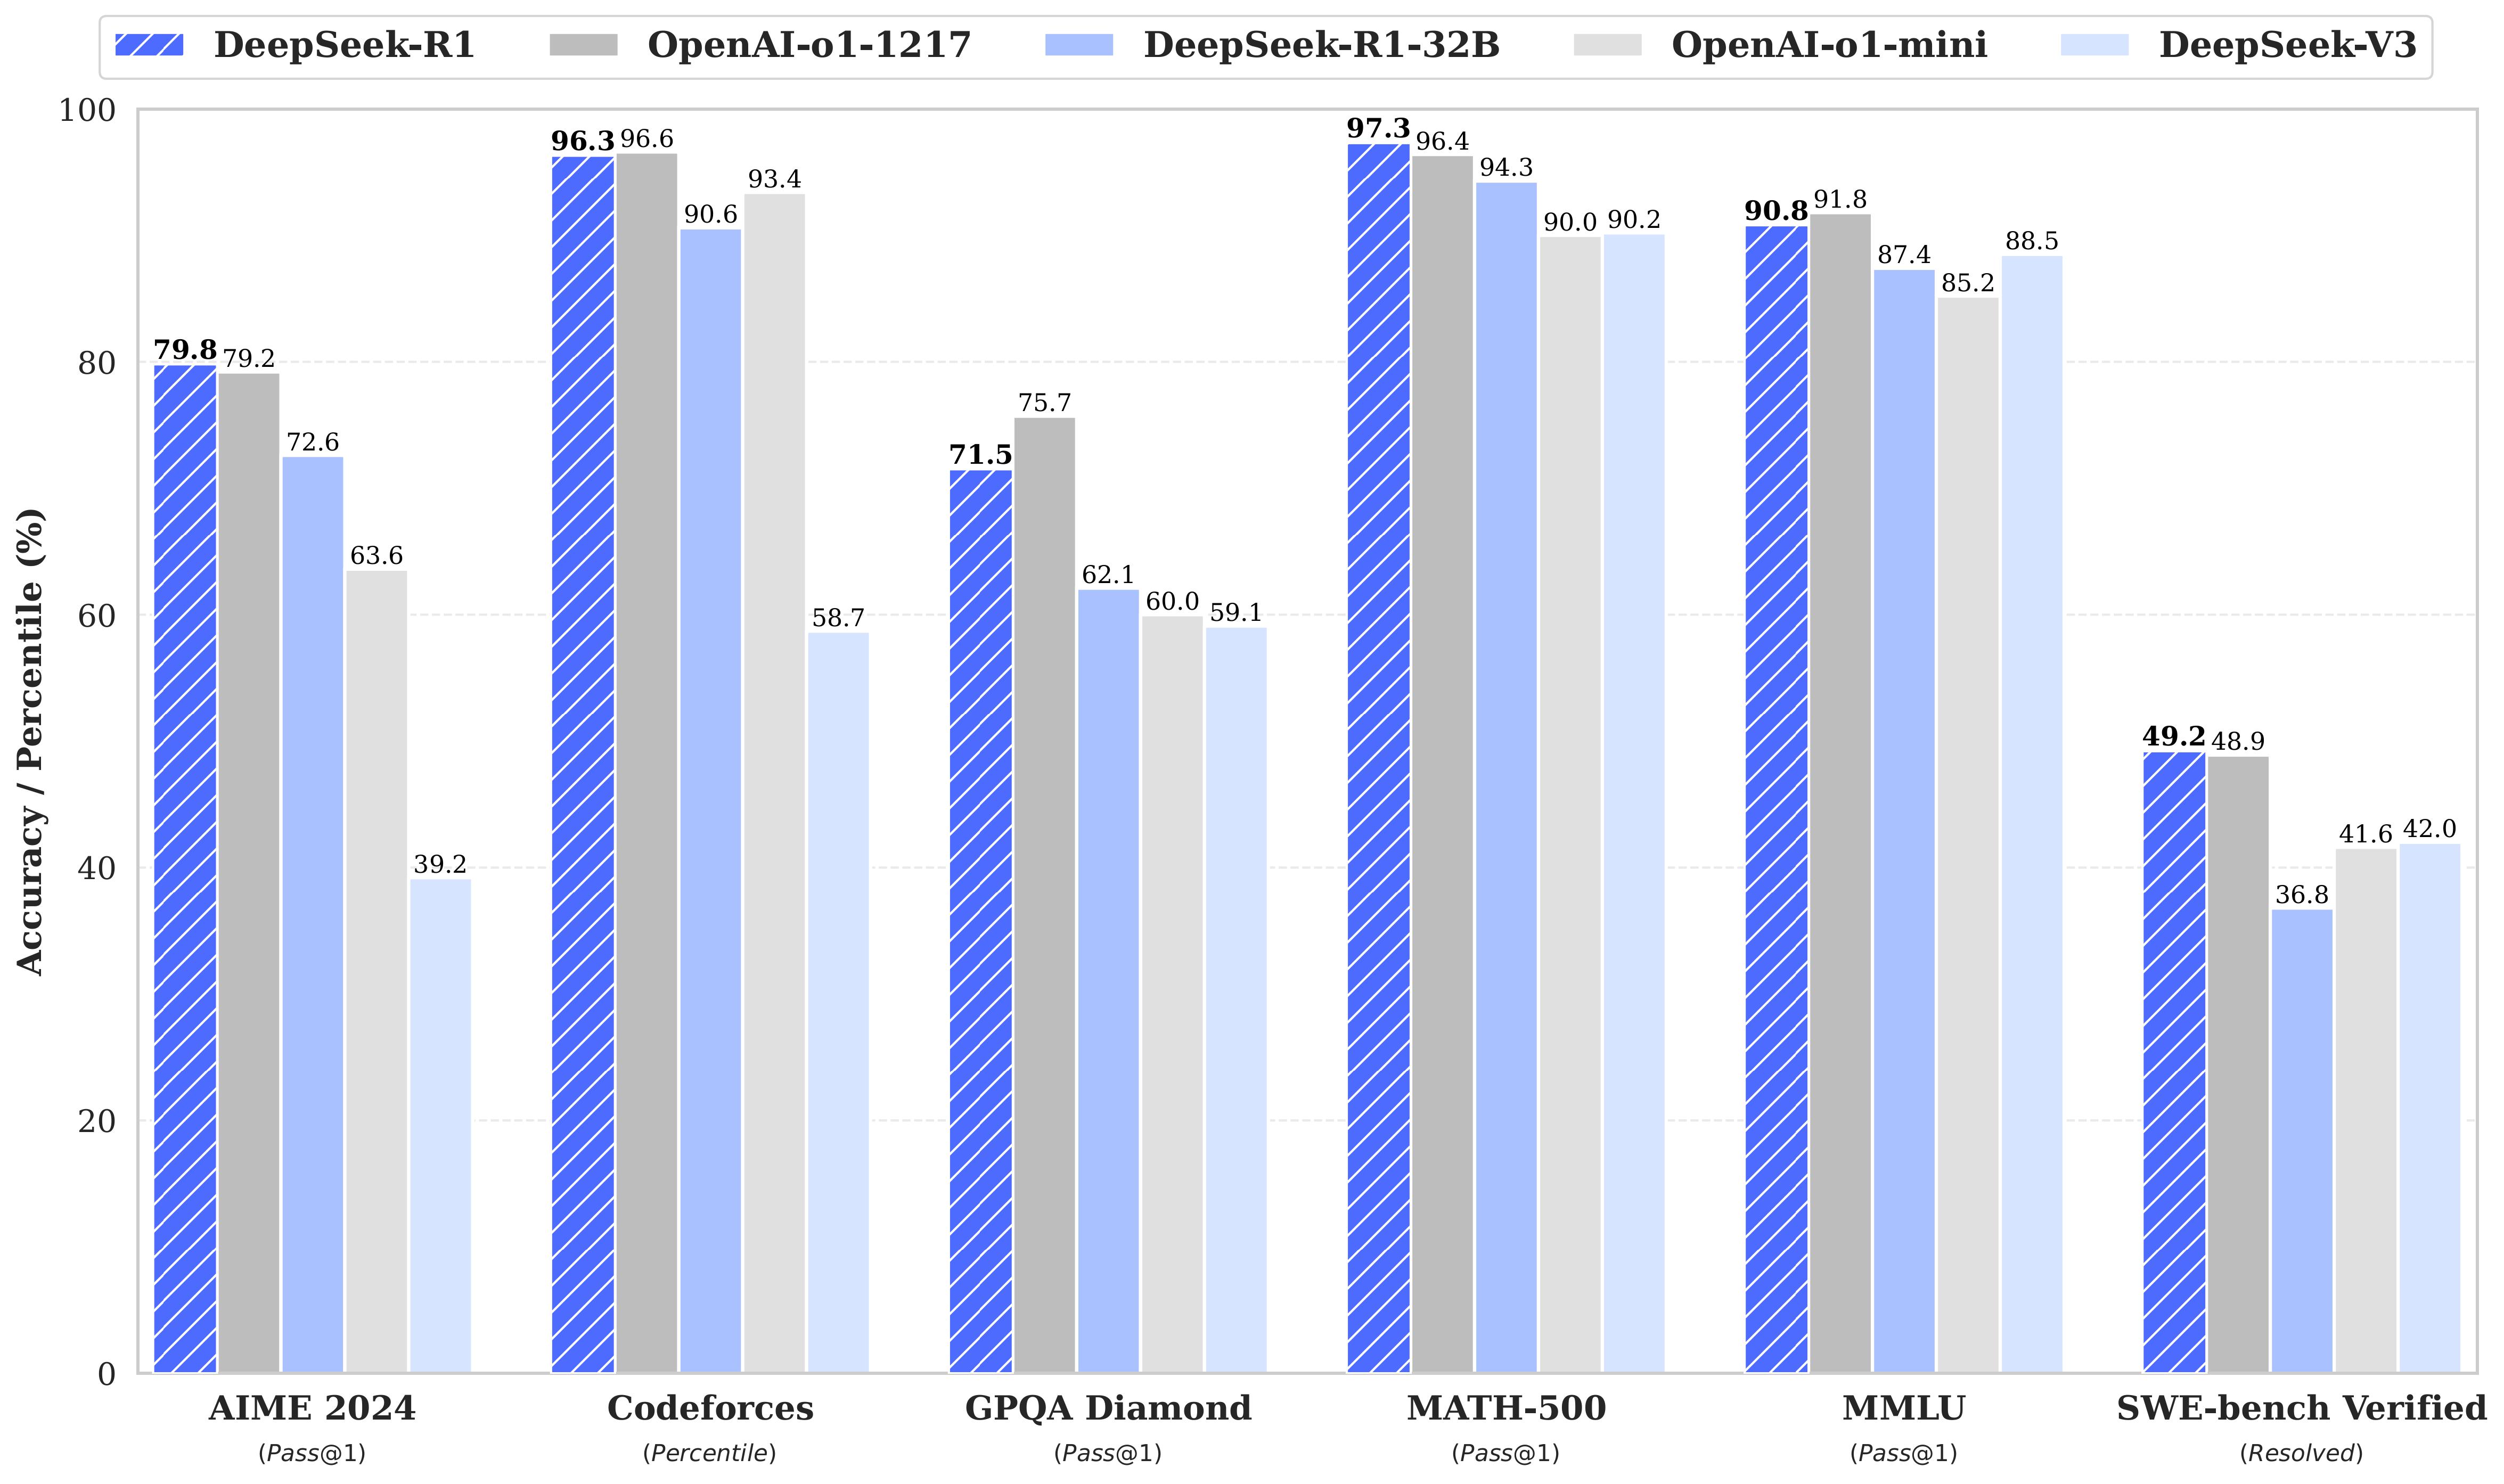
성능이 좋다는건 사용자가 원하는 답을 잘 내어준다는 의미입니다. 들리는 말에 의하면 OpenAI 의 ChatGPT o1 보다 더 좋다는 말이 있네요.
DeepSeek R1 벤치마크.
하지만 저에게 무었보다 좋은건 오픈소스라는 점 때문입니다. 이정도 성능의 모델을 오픈 소스로 풀 거라고는 생각 못했습니다. 오픈 소스로 풀린다고 해서, 당장 제가 가진 PC에서 돌려보거나 할 수는 없겠습니다만, 일단 오픈소스라는게 가장 좋아보이네요. 몇몇 사용기가 올라온걸 보면 꽤 괜찮다는것 같습니다. AI 에서 중요한 것 중 하나가 개방성인데, 거대 LLM 을 오픈하는건 중국이 미국보다 먼저 했네요.
비용이 많이 들어가는 RLHF(Reinforcement Learning from Human Feedback, 인간의 피드백에 의한 강화 학습), SFT(Supervisor Fine Tuning, 감독자에 의한 파인 튜닝)을 사용하지 않고, RL(Reinforcement Learning, 강화 학습) 만을 사용했다고 합니다. 그래서 비용이 줄었다고 하네요. 이게 대단한게 RL 만으로는 한계가 있어서 RLHF, SFT 를 사용했던건데, 다시 RL 만으로도 된다는걸 보여주는 거라고 합니다. 물론 RL 만으로 학습한게 티가 난다고 합니다만, 어느 정도일지는 사용자마다 다르겠죠. 어쨋던 대단하긴 합니다.
또한 MOE(Mixture of Experts, 전문가 혼합) 기법을 사용해 특정 주제에 맞는 부분만 활성화 시켜 연산시키기 때문에 훈련과 추론시 사용하는 메모리를 줄였고, MLA(Multi-head Latent Attention) 를 사용해 키-값을 처리해 메모리를 더 줄였습니다. 마지막으로 nVidia CUDA에서 사용하는 PTX(Parallel Thread xecution)를 적극적으로 사용해서 성능을 향상시켰습니다. PTX 는 일종의 하드웨어 독립적인 언어로, CUDA 보다도 더 저수준의 언어입니다. PTX 는 일종의 GPU용 어셈블러이긴 하지만 하드웨어 독립적입니다. (하드웨어 독립적이긴 하지만 nVidia 제품에만 사용됩니다. nVidia GPU 아키텍처에 독립적이라는 의미입니다. CUDA/PTX 를 사사용해 작성한 코드는 바이너리 코드로 변환되어 실행되는데 이 바이너리 코드를 SASS(Source and Assembly)라고 부릅니다. SASS 가 GPU에 의존적입니다) PTX 를 사용한다는게 굉장히 어려운 일이기 때문에 CUDA 정도만 사용했었는데, 중국에서는 이걸 했나보네요.
또한, 아직 추정이긴 합니다만, Distilled(추출기법)도 사용했을거라고도 생각합니다. 학습된 모델의 추론 결과를 학습할 모델의 입력으로 사용하는걸 말합니다. 쉽게 말하면 ChatGPT 의 결과를 DeepSeek 의 입력으로 사용했다는 겁니다. (이런 방식은 ChatGPT 이용 약관 위반입니다) 기사를 보면 OpenAI 에서는 어느 정도 증거를 가지고 있는것 같이 보입니다.
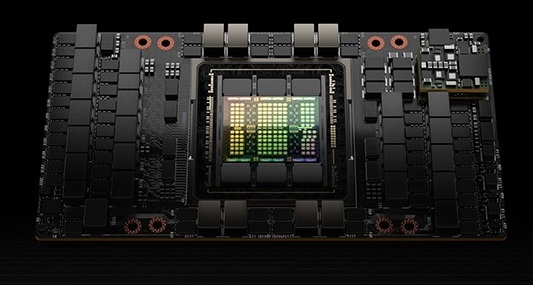
중국에 대한 수출 제한으로 nVidia H100 을 사용하지 못하는 제약때문에 nVidia H800 (H100 의 중국 수출 판)을 사용할 수 밖에 없었는데, H800 이 가진 한계(칩 간 전송 데이터 폭이 H100 의 절반, FP64 성능은 많이 떨어지나 FP32, TP32, BF16, FP16 의 연산은 성능이 동일함)를 극복한걸로 보이네요. H800 이 H100 에 비해 그렇게 떨어지는것도 아니긴 하구요.
nVidia H100
사용하는 방법에는 여러가지가 있겠습니다만 제가 본건 nVidia 에서 배포한 TensorRT-LLM - Deepseek-v3 사용 방법입니다. 여기에서는 BF16을 사용할 걸 추천하는데, 이경우 GPU 메모리가 1.3TB 이상 되어야 합니다. 모델 파일만 650GB 정도 되어보이고 모델 파일은 FP8 으로 되어있는것 같네요. 게다가 현재는 Hopper 아키텍처에서만 작동한다고 합니다
생성형 AI 를 사용하는 때에도, 중국 아니면 일본, 미국에서 만든 LoRA 가 많이 올라옵니다. 중국이 특히 많구요, 우리나라도 제법 있긴 합니다만, 다수라고 보기엔 무리가 있습니다. 그나마 오노마에이아이 (Onoma.AI) 에서 만든 Illustrious XL(ILXL) 과, ILXL 기반으로 만든 NoobAI-XL 이 생성형 AI 에서는 제법 알아준다고나 할까요. 우리나라도 어서 LLM 이 공개되었으면 하네요. 누가 공개할지는 모르겠습니다만 말이죠.